Что такое llms.txt и читают ли его ChatGPT и Алиса
Файл llms.txt владелец кладёт на свой сайт, чтобы коротко рассказать о себе нейросетям. Но ChatGPT и Алиса собирают ответы из поисковой выдачи. Роботы нейросетей мой файл за полмесяца ни разу не запросили, так что ради них он не нужен. Сначала откройте Яндекс Вебмастер и посмотрите, видит ли поиск ваш сайт.
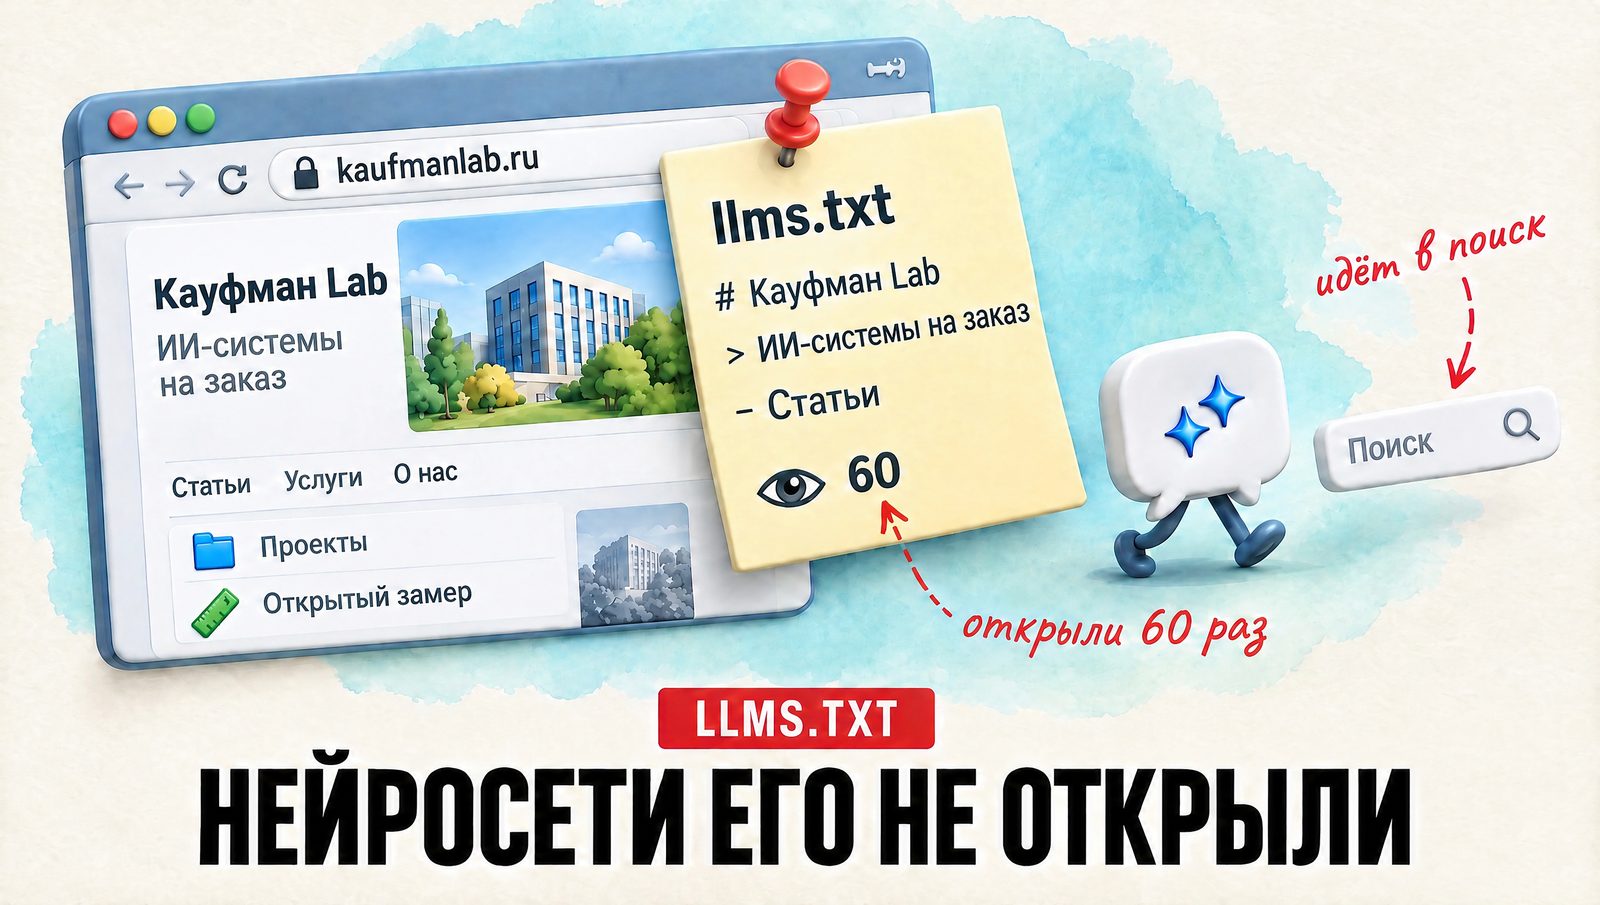
На моём сайте llms.txt появился вместе с первой версией и обновляется сам, когда меняются страницы. В конце сентября я открыл журнал сервера. Это запись о том, какая программа и в какую минуту запрашивала каждый адрес. С 16 по 30 сентября поисковый робот ChatGPT обратился к robots.txt, файлу с правилами для роботов, 202 раза. А до llms.txt, который лежит в той же папке, он так и не дошёл. Зато когда я сам перечитал файл, нашёл в нём три строки неправды о себе.
Кто на самом деле приходил за файлом
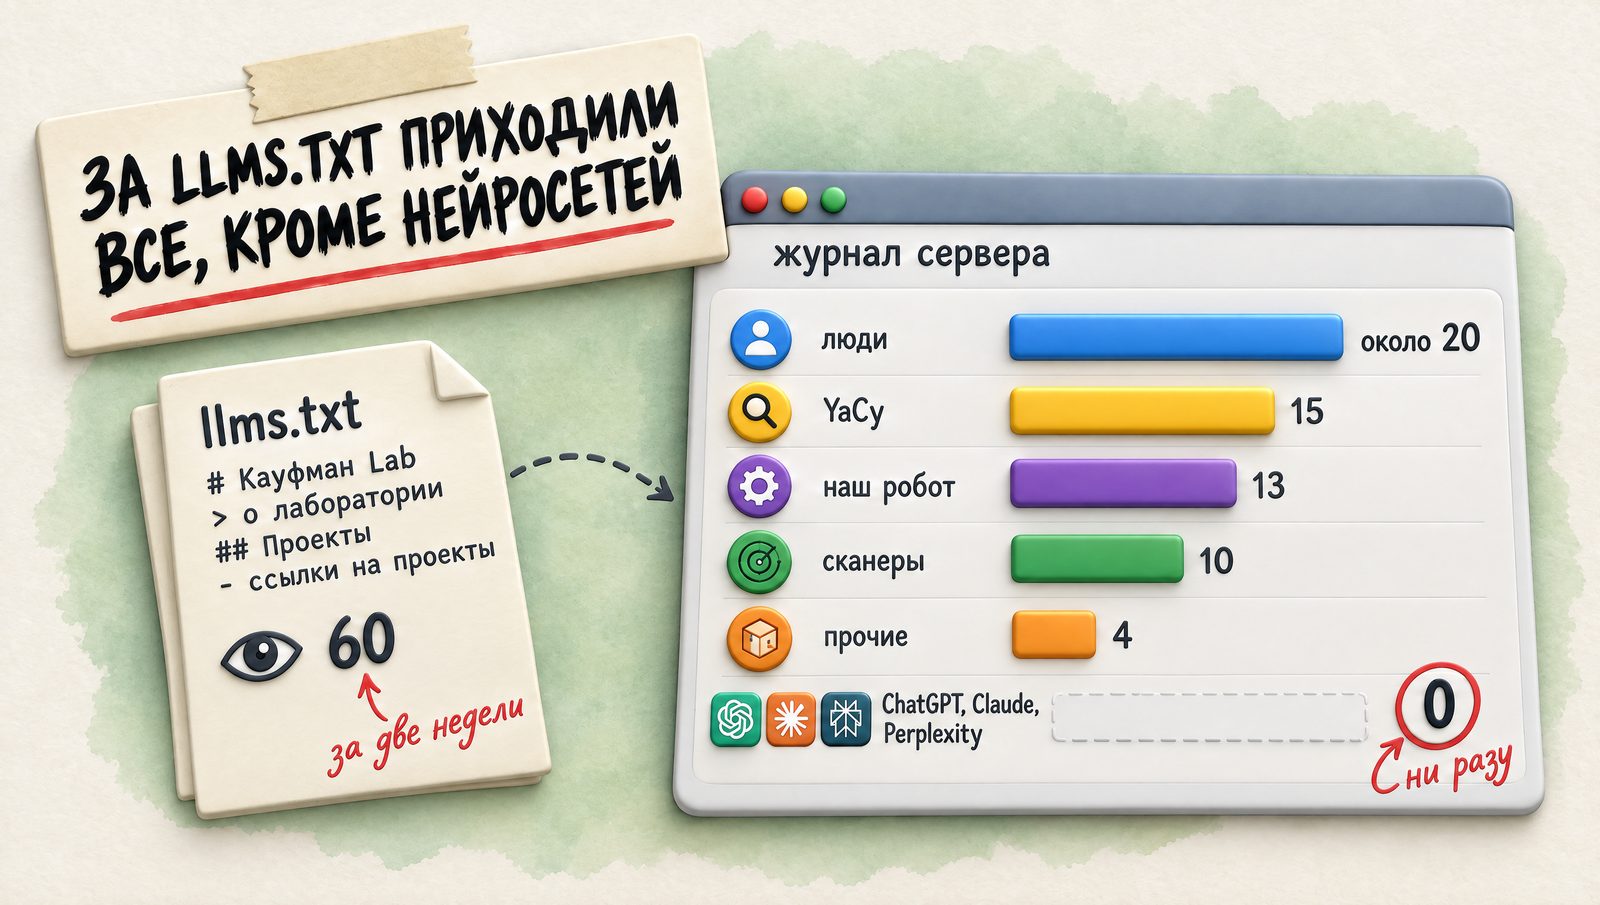
За эти дни llms.txt запросили только 60 раз, robots.txt за то же время 887. Вот кто это был:
- 15 запросов от YaCy, маленького независимого поисковика;
- 13 от моего же робота, который проверяет сайт;
- 10 от сканеров SEO-сервисов;
- примерно 20 от людей, зашедших из браузера;
- 4 от прочих программ;
- ноль от ChatGPT, Claude и Perplexity.
Один сайт мало что доказывает, но большой замер выглядит так же. В июне 2026 года сервис Ahrefs изучил 137 210 сайтов и нашёл файл у 38 360 из них. К 97 % этих файлов за весь май не обратился никто.
Сам формат придумали для программ-помощников, которые делают дело на сайте вместо человека. Описание формата на llmstxt.org так и говорит, что программа читает файл и по ссылкам в нём находит нужные страницы. Это видно и в замере Ahrefs: чаще любого поискового робота нейросетей к файлу ходил Claude Code. Это помощник, который пишет код вместе с программистом, к поисковым роботам он не относится. А все поисковые роботы нейросетей вместе дали лишь 1,1 % обращений к llms.txt.
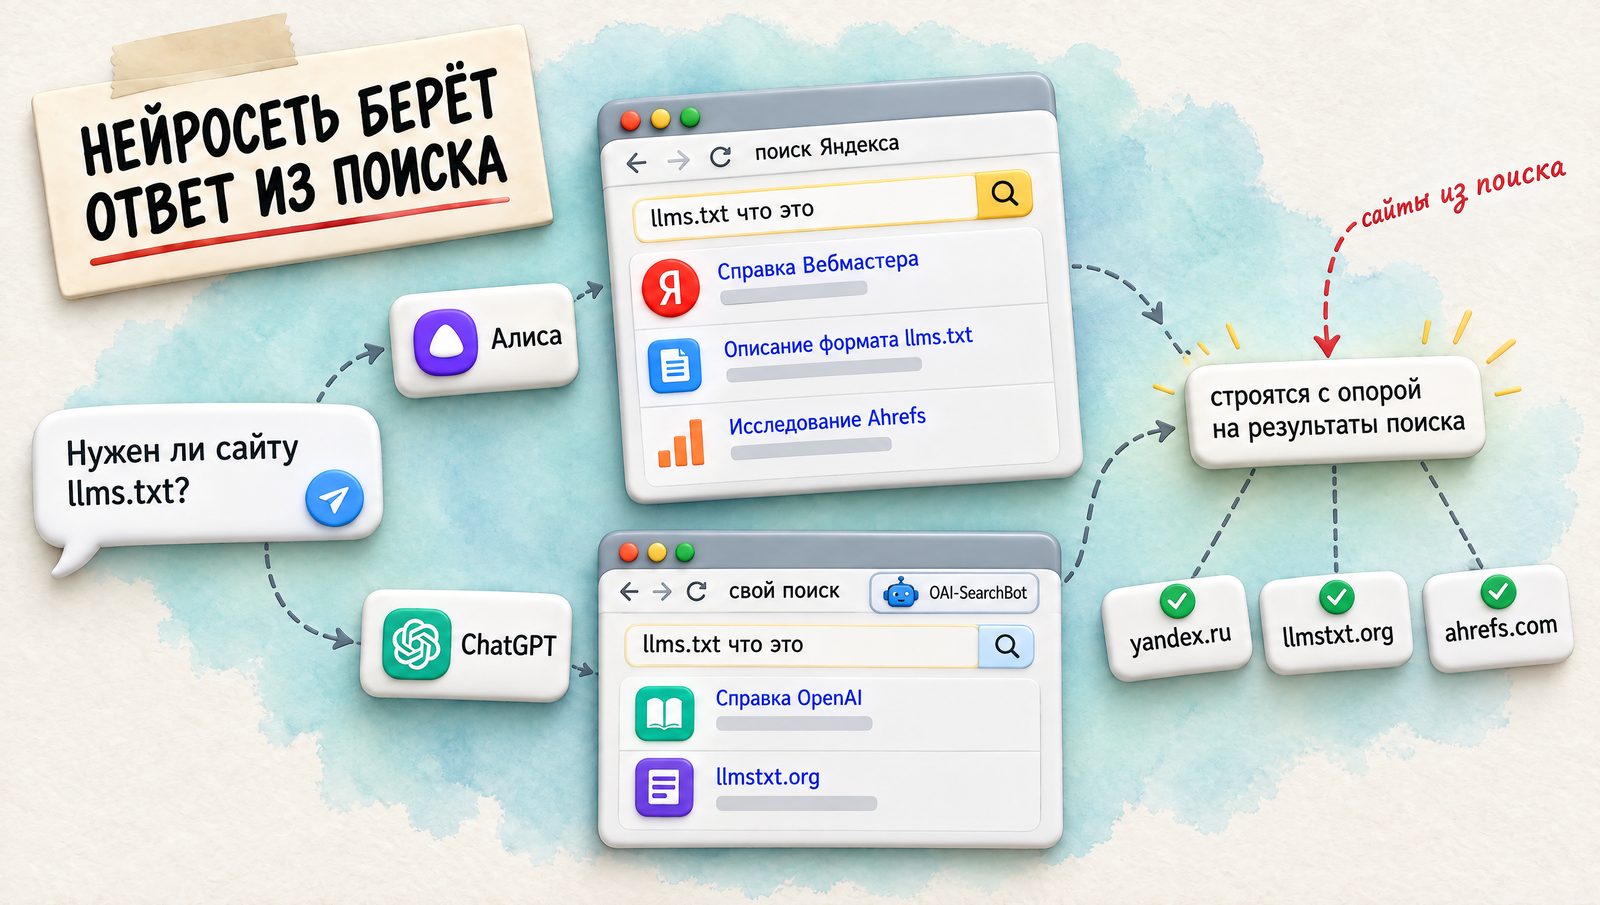
Откуда нейросеть берёт сайты для ответа?
Яндекс в справке для владельцев сайтов говорит прямо, что Алиса AI опирается на результаты поиска, и отдельных требований к сайтам из-за этого не вводит. У ChatGPT свой поиск, а за страницами для него ходит отдельный робот OAI-SearchBot. Так описывает дело сама OpenAI в справке для вебмастеров.
В июне 2026 года Джон Мюллер из Google объяснил в подкасте компании, почему файл здесь не помогает. Сайт может написать о себе «у меня лучший сайт на свете», и проверить это нечем. Добавлю от себя, что место в выдаче, в отличие от такого рассказа, проверить можно.
Что я нашёл, когда перечитал свой файл
Меня подвело то, что llms.txt пишет о сайте сам сайт, и со стороны его никто не сверяет. Мой файл собирается автоматически. Перед выкладкой проверка смотрела в нём одно лишь число проектов, а оно совпадало.
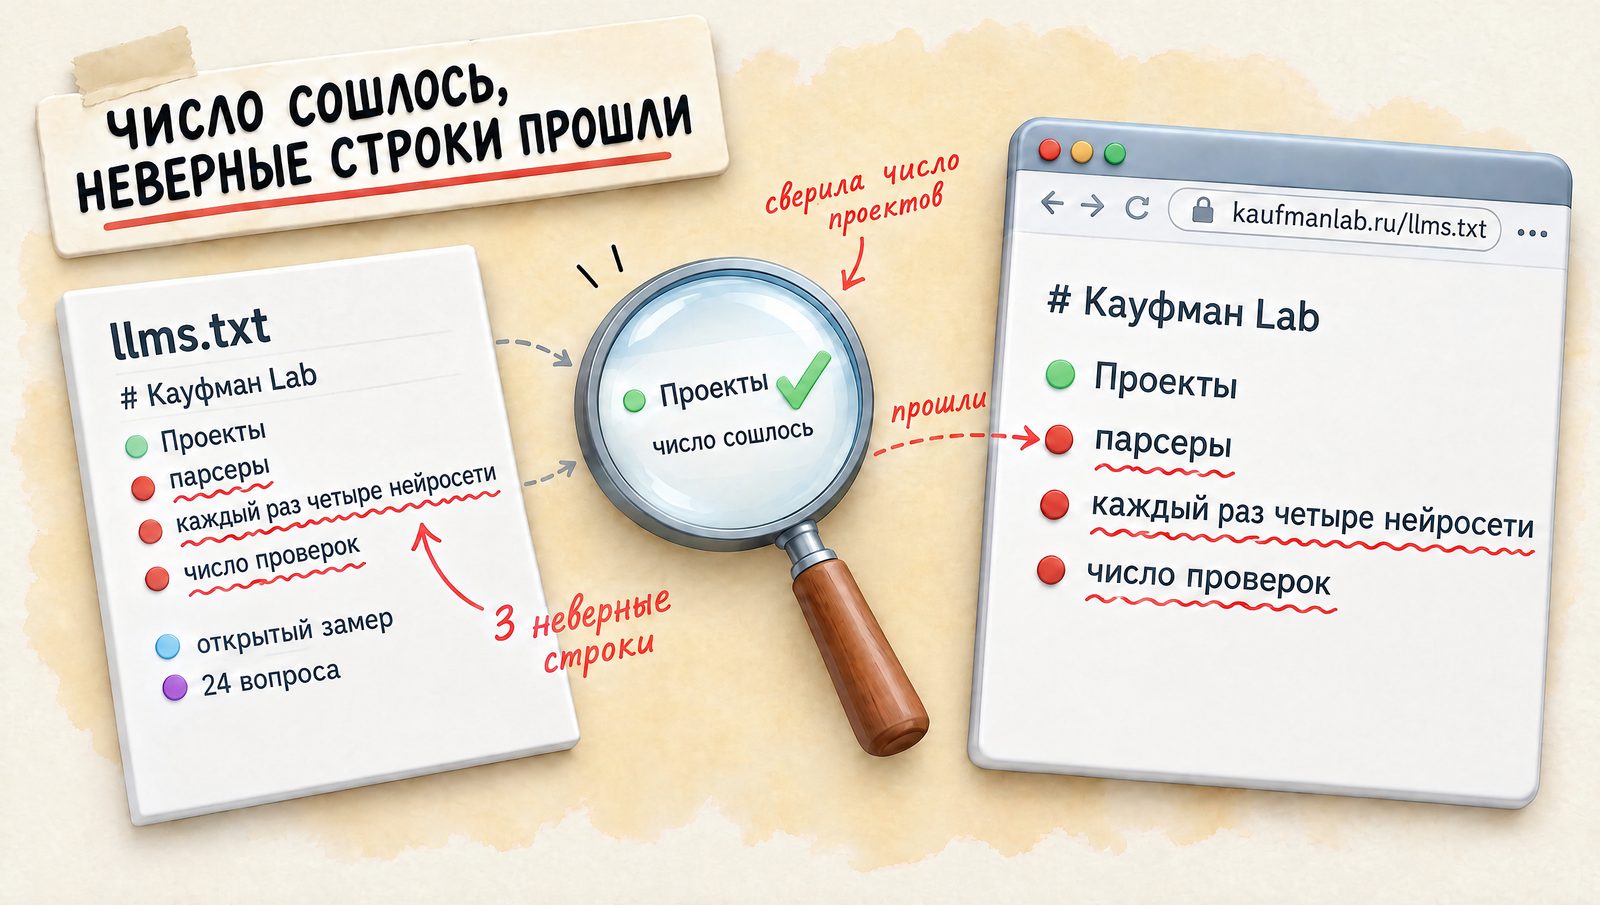
Когда я прочёл файл целиком, ошибок оказалось три. Он сообщал, что у Кауфман Lab есть парсеры, хотя таких проектов в лаборатории нет. Про мой открытый замер, где я задаю нейросетям 24 вопроса и смотрю, назовут ли они мой сайт, он писал, что нейросетей в нём всегда четыре. Во второй раз их было три. И обещал 96 проверок в каждом замере, хотя во втором набрался 71 ответ.
Все три строки я поправил 30 сентября. Пока файл читают сканеры и люди, вреда от них нет. Но программа-помощник примет написанное на веру и расскажет человеку про направление, которого нет.
Что проверить вместо файла
- Зайдите на webmaster.yandex.ru, нажмите «Добавить сайт» и подтвердите, что он ваш. На это уходит до суток.
- В отчёте «Страницы в поиске» найдите свои страницы со статусом «В поиске». После обхода робота новая страница может появляться там до двух недель.
- Откройте ваш-сайт.ru/robots.txt. Пара строк «User-agent: *» и «Disallow: /» закрывает для роботов весь сайт. Если вместо звёздочки там стоит OAI-SearchBot, ваш сайт не попадёт в ответы поиска ChatGPT. Такой запрет надо снять.
Если файл от генератора у вас уже есть, возьмите страницу услуг и пройдите его построчно. Всё, чего на сайте нет, вычеркните, а каждое число сверьте с цифрой на странице. Если файла нет, ради нейросетей его не делайте. Он пригодится, если на сайте есть документация для программистов и по ней ходят программы-помощники. Тогда обязателен в нём только заголовок с названием сайта после знака #, дальше идут короткое описание после знака > и ссылки на главные страницы.
Пока сайта нет в поиске, я бы не тратил на llms.txt даже вечер: в ответ нейросети он не приведёт.
А вы когда-нибудь открывали журнал своего сервера?
Роман Кауфман, основатель Кауфман Lab